В SuzMark предусмотрена функция распознавания Data Matrix из PDF-файлов. Программа позволяет извлечь коды маркировки из ранее сформированного документа и получить их для дальнейшей работы.
Пригодится, если исходный заказ или список кодов утрачен, но сохранился ранее сформированный PDF-файл с этикетками.
Как работает
Программа распознаёт коды Data Matrix на страницах PDF-файла с этикетками.
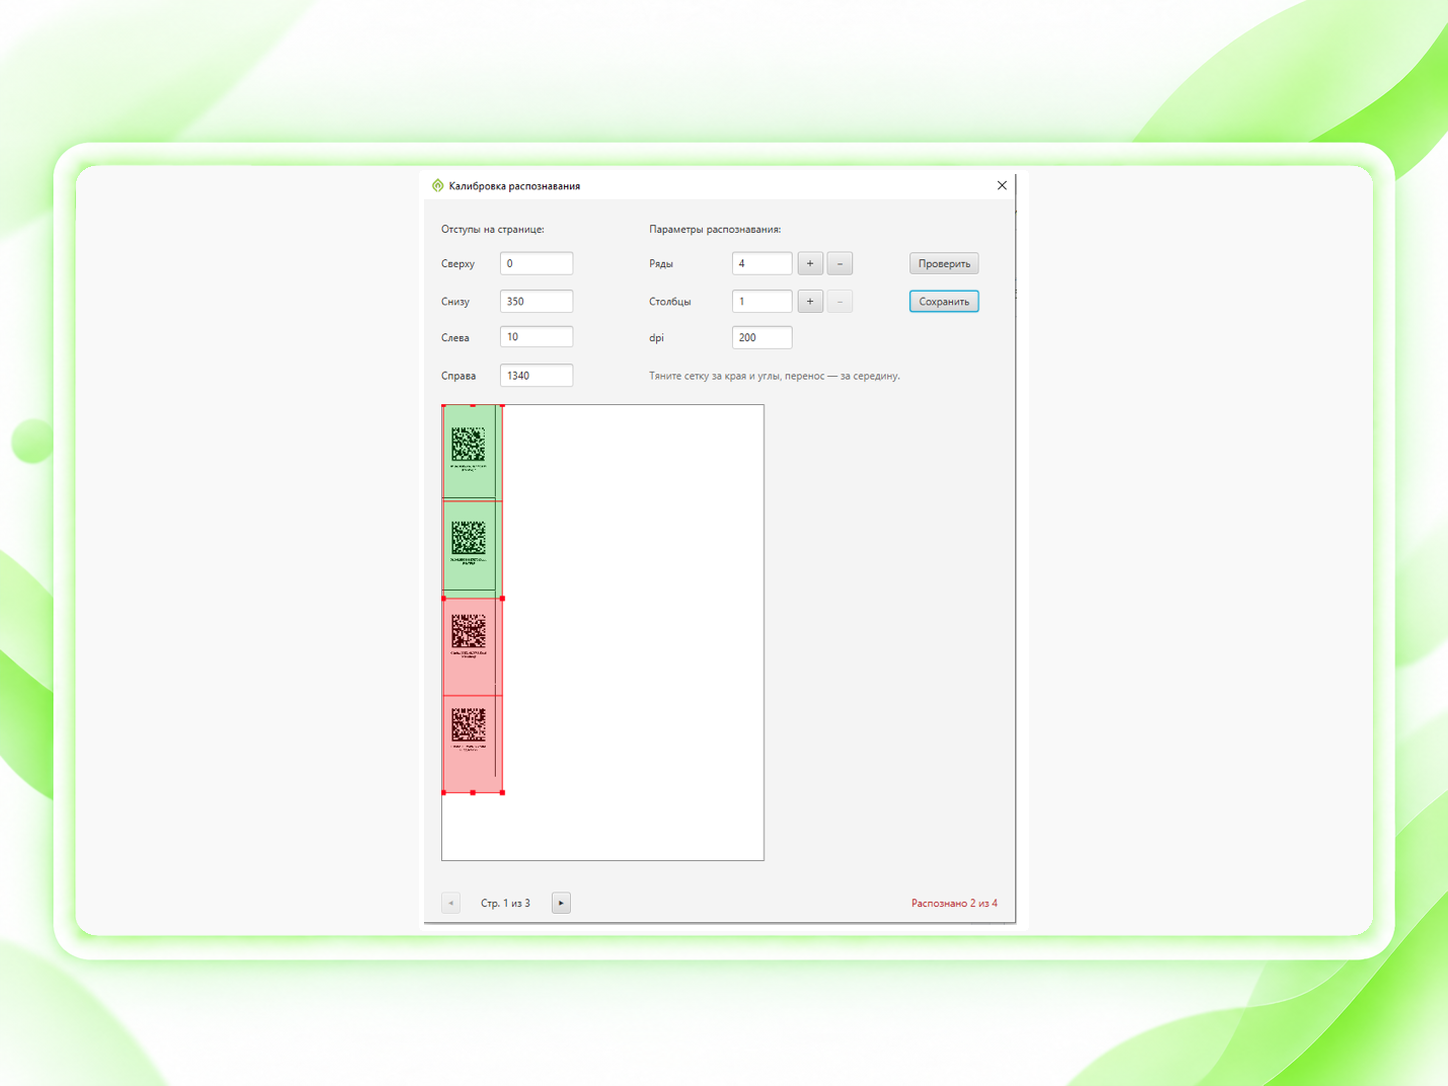
Для этого необходимо настроить расположение кодов на странице: указать отступы сверху, снизу, слева и справа, а также количество столбцов.
После настройки проверить, правильно ли программа определяет коды, сохранить параметры и запустить обработку файла.
Как извлечь коды маркировки из PDF
Шаг 1.
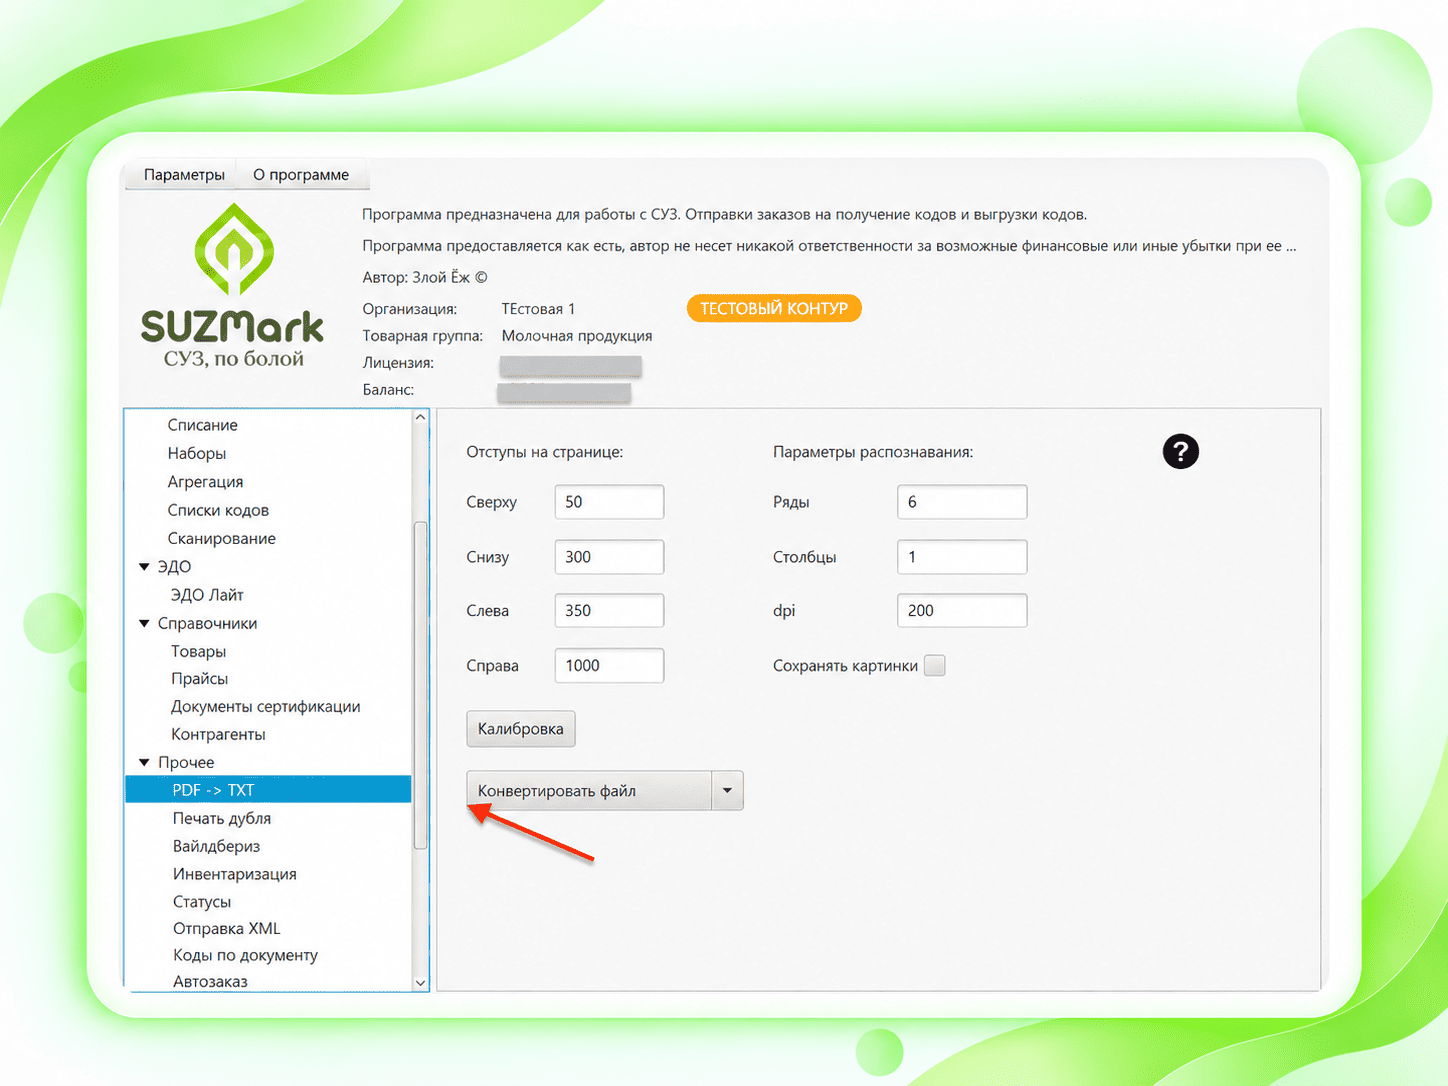
Откройте инструмент распознавания PDF
Шаг 2.
Настройте расположение кодов на странице
В окне настройки укажите отступы от краёв страницы: сверху, снизу, слева и справа.
Задайте количество столбцов в соответствии с расположением этикеток в PDF-файле.
Выполните проверку распознавания. Программа покажет, сколько кодов удалось определить на проверяемом макете.
Шаг 3.
Проверьте распознавание и сохраните настройки
После задания параметров нажмите кнопку проверки.
Если программа правильно определила расположение Data Matrix, сохраните настройки.
Шаг 4.
Запустите распознавание PDF-файла
После сохранения настроек выберите PDF-файл, из которого необходимо извлечь коды маркировки.
Запустите обработку и дождитесь её завершения.
SuzMark распознает коды Data Matrix, расположенные на страницах документа.
Шаг 5.
Получите восстановленные коды маркировки
После обработки файла программа показывает распознанные коды.